
1 位老师,数百名学生
一对一模拟面试是最有效的面试训练,也是就业指导中最难规模化的环节。约学生、排时间、做记录,逐人跟进耗尽精力,覆盖率始终上不去。
每一次面试机会都值得被认真准备
1270万人
2026 届高校毕业生规模
同比增加 48 万,约为十年前的 1.66 倍,再创历史新高
约 3倍
青年失业率相对整体的倍数
16–24 岁(不含在校生)失业率长期运行于 15%–17%,整体约 5%
2032年
高等教育学龄人口达峰年份
千万级毕业生规模将长期持续,供给压力短期无解
数据来源:教育部(2026.6,新华社通稿)、国家统计局(2026.6)、求是网《持续促进青年群体高质量充分就业》(2026.5)。
教育部 2025 年启动高校毕业生就业能力提升「双千」计划,就业能力培训已成国家政策导向。
一对一模拟面试的效果没人质疑,难的是怎么让几百人都练得上
一对一模拟面试是最有效的面试训练,也是就业指导中最难规模化的环节。约学生、排时间、做记录,逐人跟进耗尽精力,覆盖率始终上不去。
学生练了几场、弱在哪个维度、有没有提升——无从量化,也就无法向院系汇报。就业质量报告里能填的,往往只有一张签约率表格。
学校买了服务,总要回答「用得怎么样、有没有效果」。拿不出数据,就只能靠感觉,来年预算也不好谈。
不是把 AI 套在面试上,而是按成熟的学习科学来设计训练方式
2 Sigma 问题
布卢姆 · 1984
教育学经典对照实验:一对一辅导 + 学会才进阶,能让大班里成绩中游的学生冲进前 2%——但人力给不起,无法普及。
每个学生都有一个随叫随到的面试官,不用排队等老师
测试效应
Roediger & Karpicke · 2006
记忆科学中被反复验证的结论:主动回忆、被提问,比反复阅读同样的资料记得牢得多。
练的是「开口回答」,不是背面经
最近发展区与脚手架
维果茨基 · 1930s
人在「差一点就能做到」的区间学习效率最高;恰到好处的提示给台阶、不给答案。
面试中实时提示要点,卡壳时推一把
脚手架渐进撤除
Wood, Bruner & Ross · 1976
像盖楼的脚手架:支撑随能力提高逐步撤除,目标是最终不需要支撑、独立完成。
提示可多可少,练熟了就少用,最后不用也答得出来
认知负荷理论
斯威勒 · 1988
大脑一次只能处理约 4 个信息组块;一次塞进太多改进点,反而什么都学不进。
一次只让学生改一件事,改完了再说下一件
评分标准参照结构化面试(统一问题、统一评分标准)。以上理论用于说明产品的设计取向,不构成对评分效度的实证主张。
上线前要做的准备工作,被压缩成发一个二维码
一个班一个码。定好这个班多少人、能用多久、每人送几次。
生成链接与二维码,发班级群、贴在就业指导课的 PPT 上都行。不需要上传名单,也不需要导学号。
学生扫码就能注册,次数当场到账,不用等谁审批,当天就能练第一场。
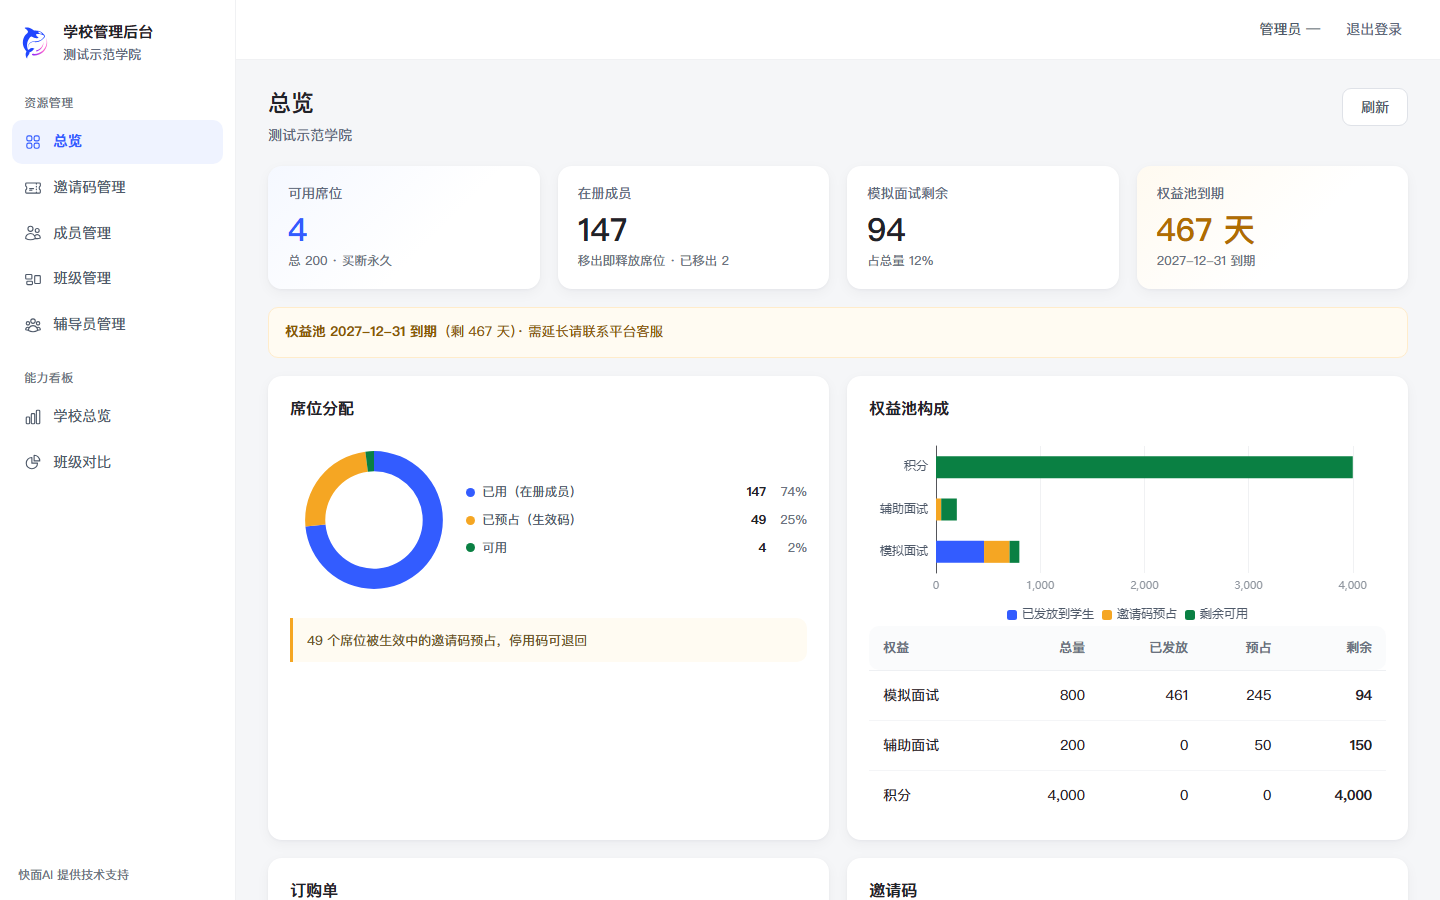
谁在练、练得怎么样、哪个班落后了、谁该被提醒,打开后台就能看到。
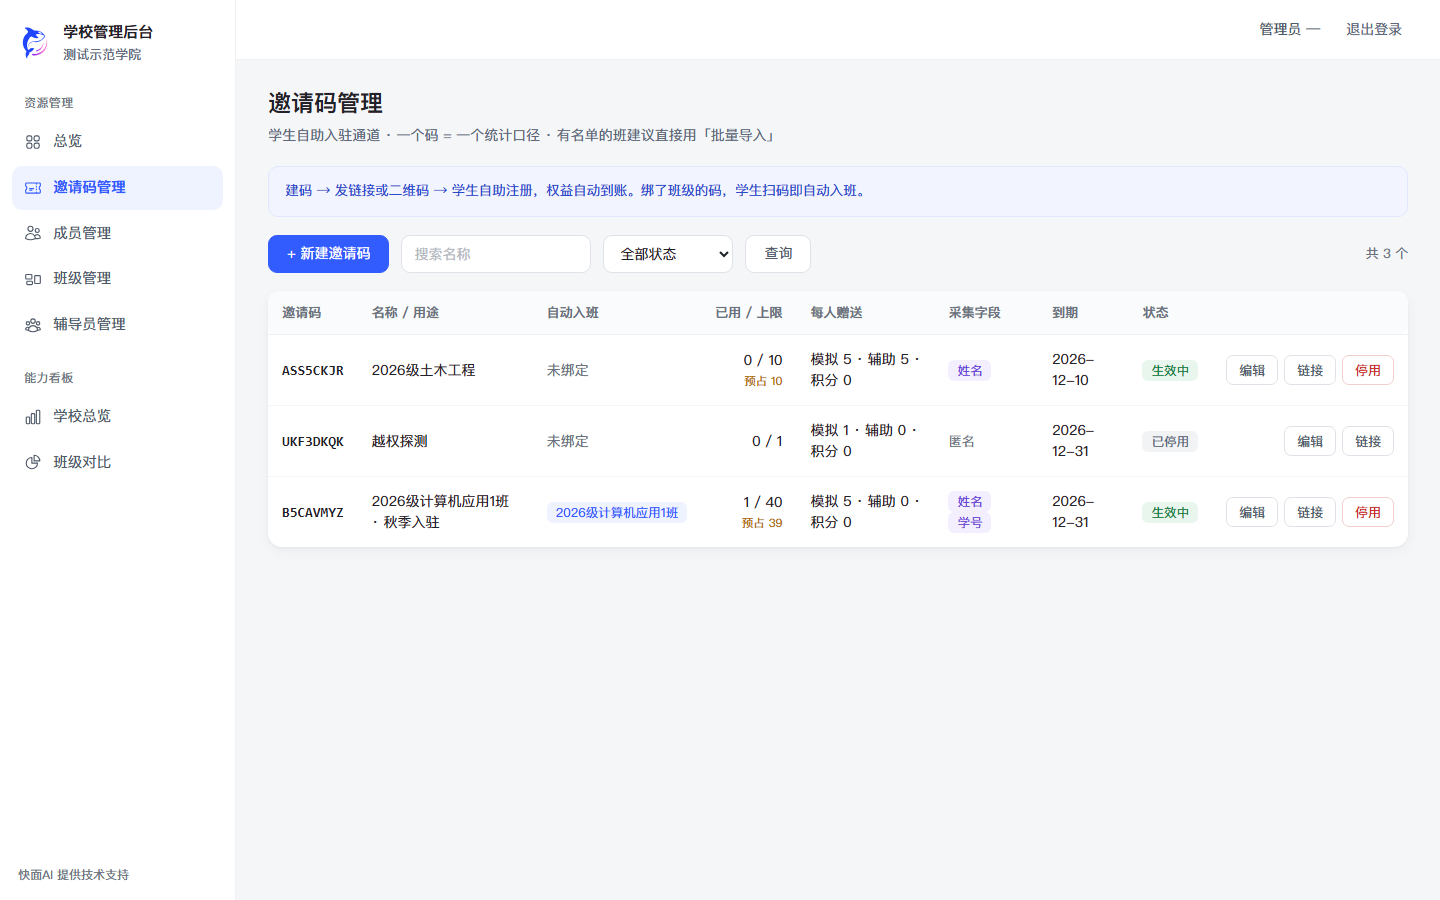
学校端最怕的是「上线前的准备工作」。快面AI 把它压缩成一件事:发一个二维码。
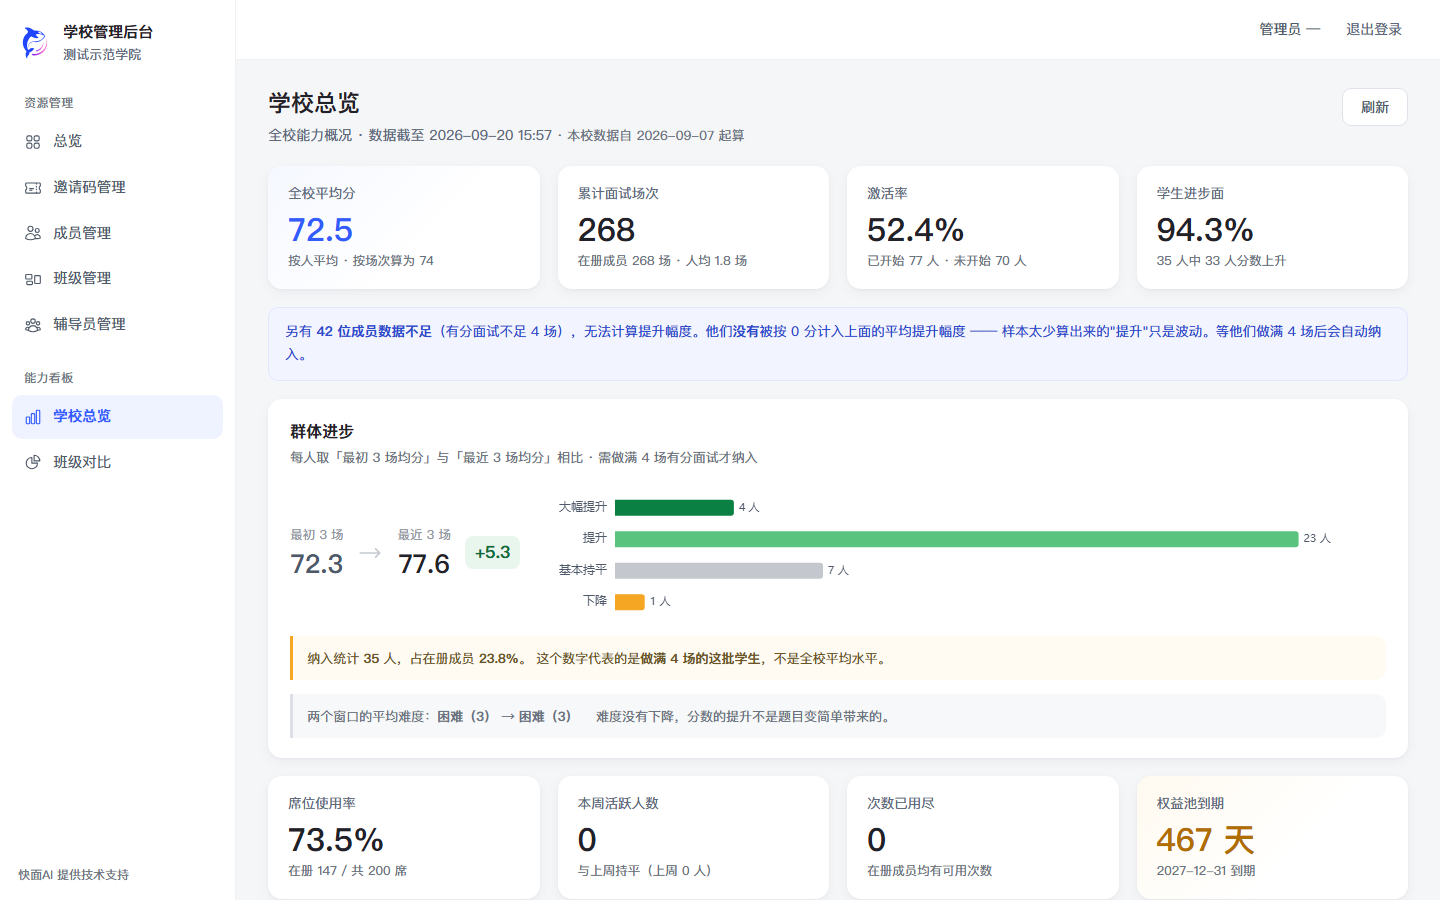
这几个数可以直接写进就业质量报告,不用你再去整理。
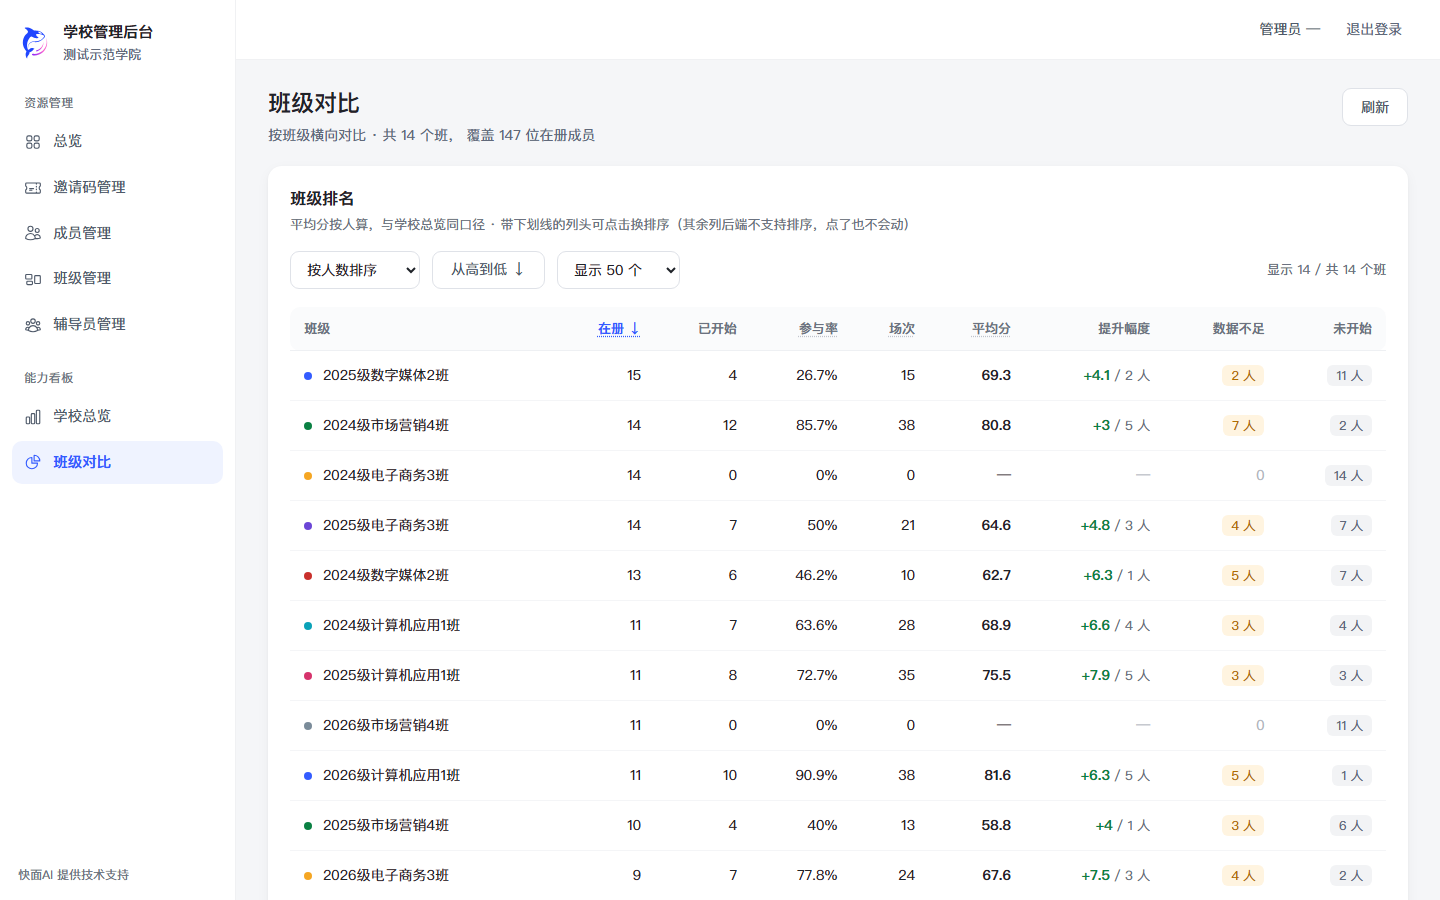
全校平均分看不出问题。有用的是哪个班落后了,以及那几个需要你单独提醒一句的学生。
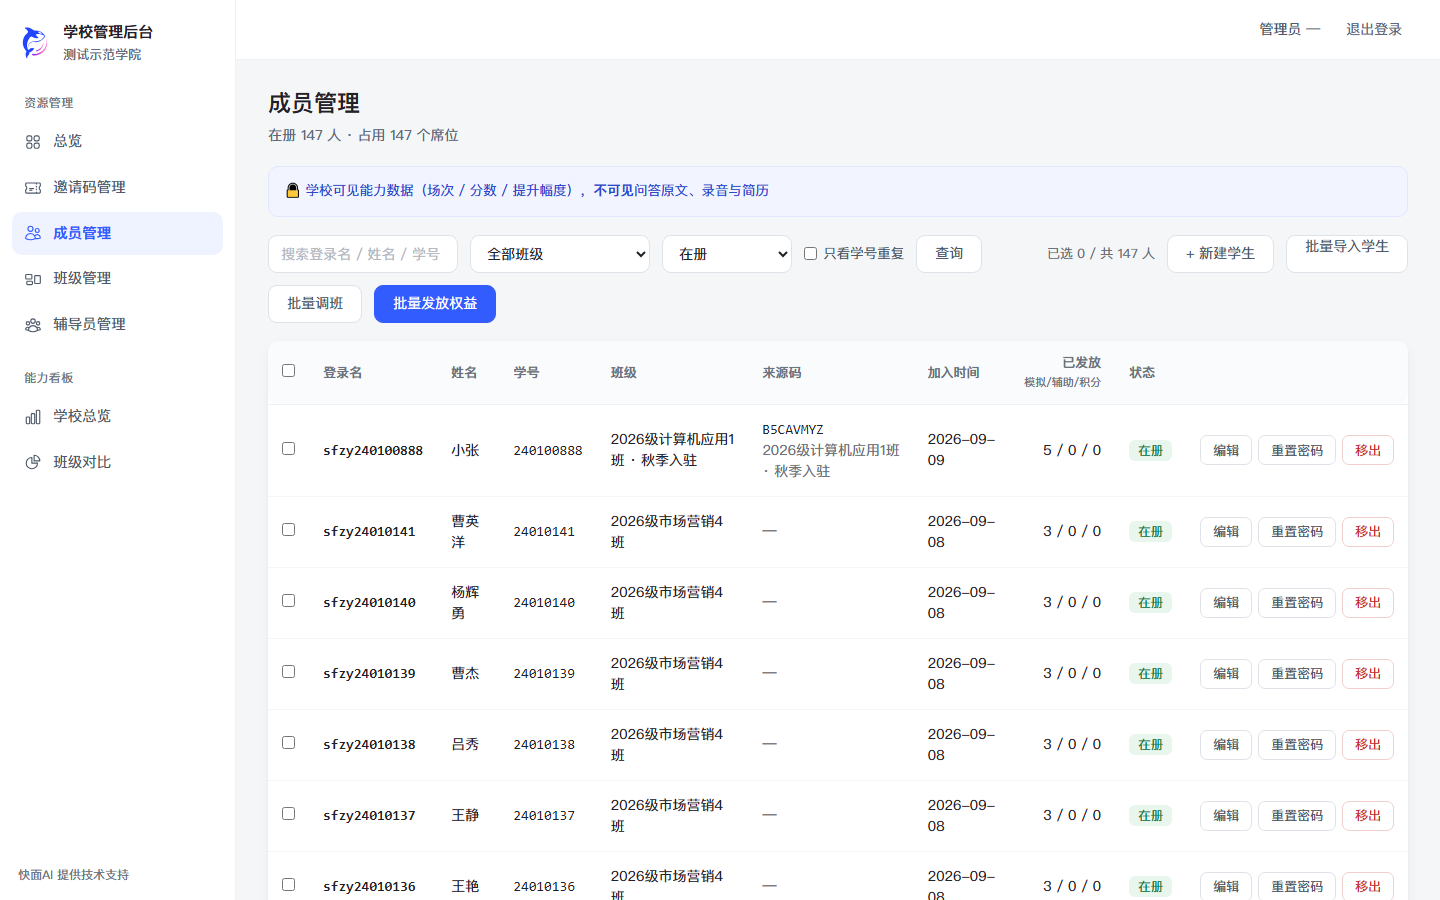
老师看得到学生练得怎么样,看不到学生具体说了什么。这句话就印在后台每一页成员列表的顶部。
学生怕被老师看到自己答得不好,就不会认真练。把这条说在前面,他们才敢放开了用。
一个二维码就够了。不用交名单、不用导学号、不用给每个学生建账号发密码。建好班级码发到群里,学生自己扫码注册,次数当场到账就能练。已经有名单的学校想直接导入也可以。
看不到。老师能看到的只有学生练了几场、得了多少分、哪个维度弱、有没有进步;学生说过的话、面试录音、简历和联系方式都看不到。这不是靠规定约束的,系统本身就不会把这些内容给到学校端。后台成员列表的顶部也写着这句话,学生随时可以核对。
拿这个学生最近三场的平均分,和他最早三场的平均分比一比,差多少就是进步了多少。练满四场才会开始算——只练一两场就下结论,波动太大不作数。没算出来的显示「—」,不是 0 分,也不会拖累全班平均,等他多练几场自动就有了。
把毕业生从成员列表移出即可,席位随之释放给新生使用。被移出的学生账号自动转为个人版,此前的面试记录与能力报告全部保留,学生可以继续自己使用。
可以。我们支持先开一个班试点,跑完一轮拿到真实的看板数据再决定是否扩大范围。发邮件到 service@kuaimian.net 约演示即可。